
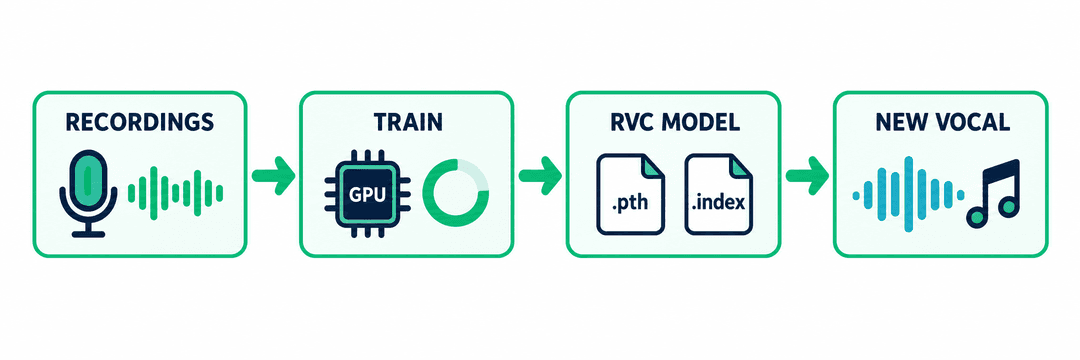
結論: RVCモデルとは、RVC(Retrieval-based Voice Conversion)で作る小さなAIボイスモデルです。RVCはオープンソースの技術で、録音された声を別の声に置き換えつつ、歌詞・メロディ・タイミングはそのまま残します。学習済みのRVCモデルは通常2つのファイルで構成されます。声の重みが入った.pthファイルと、元の話者や歌手により近い声にするための.indexファイル(任意)です。1人の声のクリアな録音が数分あれば学習できます。
AI音楽の世界で「RVC」と言えば、ほぼこの声質変換モデルのことです。「RVCボイスクローン」は、特定の声でこのモデルを学習させることを指します。ネットで公開されているAIカバー曲の多くが、RVCで作られています。
RVCとは何の略?
RVCは Retrieval-based Voice Conversion(検索ベースの声質変換) の略です。RVC-Project が2023年にMITライセンスで公開しました。一般向けのNVIDIA製グラフィックボードで動き、従来の手法より少ない学習音声で済むことが多いため、オープンソースの声質変換として最も広く使われるワークフローのひとつになりました。
ポイントは「声質変換」という部分です。RVCは作詞も作曲もしません。既にある歌声を別の声で歌い直させるもので、元の歌手の歌い回し・音程・リズムはそのままに、声色だけが学習した声に変わります。
RVCボイスチェンジャーとは?仕組みは?
RVCボイスチェンジャーとは、RVCモデルを読み込んで録音を変換するツールの総称です。かんたんに言うと、変換する歌声ごとに次の3つの処理をします。
「何を歌っているか」と「誰が歌っているか」を切り分ける。 音声モデル(HuBERT / ContentVec)が入力された歌声を、発音の内容を表す特徴量に変換します。この特徴量には歌手本人の声色がほとんど含まれません。
音程を追う。 ピッチ抽出器(定番はRMVPE。CrepeやHarvestも選べます)がメロディを追いかけ、変換後の声が同じ音程で歌えるようにします。男声から女声、女声から男声に変えるときは、1オクターブ上下させることもできます。
ターゲットの声で音声を作り直す。 学習済みの生成器が、特徴量と音程をターゲット話者の声色で音声に戻します。
名前にある「Retrieval(検索)」は、その途中に入る任意のステップです。音声を作り直す前に、学習用録音(.indexファイルに保存されたもの)から最も近い音を探し、特徴量をそちらに少し寄せます。これにより、ターゲットの声の本物らしさに近づくことがあります。
変換はかなり近い再現ですが、完璧なコピーではありません。元の歌声やモデルによっては、音程の揺れ、子音のつぶれ、息っぽいノイズが聞こえることがあります。
RVCモデルの.pthと.indexファイルとは?
「RVCモデル」を共有・販売するとき、それは次のファイルを指し、たいてい1つのzipにまとめられています。
| ファイル | 中身 | 一般的なサイズ(RVC v2) | 必須? |
|---|---|---|---|
| .pth | 学習済みの声の重み。声そのものにあたる部分 | 多くは約55 MB | 必須 |
| .index | 学習音声の特徴量を検索できるインデックス。検索ステップで使用 | 約15 MBから数百MBまで | 任意だが、同梱されることが多い |
正確なサイズは、サンプリングレート、学習ツール、インデックスに残す特徴ベクトルの数によって変わります。.indexファイルは任意です。なくても変換はでき、その場合は.pthだけで処理します。.indexがあれば、「index rate」の設定で出力を学習した声にどれだけ寄せるかを調整できます。上げると似やすくなりますが、こもった音やシャリシャリした音が混ざることもあり、学習音声にノイズが多いと特に目立ちます。「高いほど良い」ではなく、バランスで決めるものです。
インデックスは重みよりずっと大きくなることがあります。私たちのテストでは、分離済みの歌声約15分で学習したところ、55 MBの.pthに対してインデックスは136 MBになりました。さらに、学習スクリプトが残す132 MBのtotal_fea.npyという作業ファイルもできましたが、これは変換(推論)ではまったく使われません。
RVC v1とRVC v2の違いは?
現在はほぼ全員がRVC v2を使っています。v2は入力からより豊かな768次元の特徴量を抽出し(v1は256次元)、特に歌声でよりクリアで自然な結果になりやすいです。モデルは32・40・48 kHzで学習でき、音楽では48 kHzが一般的です。
v1とv2のモデルに互換性はありません。変換ツールは.pthファイルがどちらのバージョンかを知る必要があり、現在メンテナンスされているツールのほとんどはv2前提で作られています。
RVCモデルはどこから手に入る?
入手先は2つあります。
共有されているモデル。 コミュニティサイトやリポジトリには何千ものRVCモデルがあり、実在の歌手・俳優・キャラクターの声をまねたものも多くあります。ほとんどは声の持ち主の許可なくアップロードされ、ライセンスもはっきりしないことが多く、推論に使えるモデルではなく学習途中のチェックポイントが混ざっていることもあります。特に公開する作品に使うなら、慎重に扱ってください。
自分で学習したモデル。 自分の声、または明確に許可を得た声で学習すれば、こうした問題は避けられます。まだ誰も公開していない声のモデルを手に入れる方法も、これしかありません。
他の人の声でカバーを歌わせたい場合は、AIカバー曲を合法的に作るためのガイドで同意と著作権の問題を詳しく解説しています。
RVCモデルの作り方(学習方法)
どのRVC学習環境でも、手順は同じです。
1人の声のクリアな音声を集める。 歌(または話し声)が5〜15分ほどあれば、たいていは十分です。長さよりも、低音・中音・高音までの幅広さのほうが大切です。
声以外の音をすべて取り除く。 伴奏、リバーブ、ハモリ、他の歌手の声は、すべて声の一部として学習されてしまいます。完成した曲しか手元にない場合は、ボーカルリムーバーが役立ちます。
スライスと前処理。 音声を短く区切り、無音部分を除き、音程と特徴量を抽出します。
決めたエポック数だけ学習する。 1エポックは学習音声を1周することです。エポックを増やすほど時間がかかり、効果は少しずつ頭打ちになります。
インデックスを作ってエクスポートする。 結果として.pthファイルと.indexファイルができあがります。
どこで学習できる?
| 方法 | 必要なもの | 向いている用途 | 注意点 |
|---|---|---|---|
| ローカルのRVC WebUI(またはApplioなどの派生版) | 比較的新しいNVIDIA GPU、Python環境、ディスク容量 | 細かく制御でき、学習ごとの費用はかからない | 導入に手間がかかる、ドライバーのトラブル、数十項目の設定調整 |
| Google Colabノートブック | Googleアカウント。安定してGPUを使うには有料プランが必要なことが多い | ローカルにGPUがない | セッションが切れる。ノートブックや規約の変更で動かなくなるので、Colabの最新の規約を確認 |
| 開発者向けAPI(例:Replicateの train-rvc-model) | APIアカウントと、データセットをzipにまとめる手段 | 自分のアプリに学習機能を組み込む | ファイルの準備、Webhook、ストレージはすべて自前で対応 |
| 有料の学習代行サービス | 他人の作業時間 | 単発でモデルを作りたい | 納期、録音データのプライバシー、品質のばらつき |
| RaoMusicのようなオンライン学習ツール | ブラウザと自分の録音 | GPUも環境構築もなしで学習し、すぐにその声を使いたい | 学習1回ごとにクレジットがかかる |
RVCモデルは無料でオンライン学習できる?
一部は可能です。RVCのソフト自体は無料のオープンソースなので、十分な性能のNVIDIA GPUがあれば、自分のPCでの学習にかかるのはハードウェアと電気代だけです。無料のオンライン手段はそれほど頼れません。Colabの無料GPU時間には制限があり、学習の途中でセッションが切れることがあります。コミュニティのノートブックは依存関係が変わると動かなくなり、学習APIの無料枠(ある場合)にも上限があります。学習にはGPU時間が必要なので、RaoMusicを含め、安定したオンライン学習ツールは有料です。「無料」を最優先するならローカル学習が現実的です。GPUがない、または環境構築をしたくないなら、オンライン学習でその手間を省けます。
RaoMusicでRVCボイスモデルをオンライン学習する方法
RaoMusicのAIボイスクローンなら、上の工程をすべてブラウザ上で完結できます。
自分で歌った音声を8〜15分追加する。 ファイルをアップロードするか、ライブラリから曲を選びます。伴奏は自動で除去され、無音部分もカットされます。
学習品質を選ぶ。 標準(50エポック)、高品質(100)、最高(150)で、それぞれ150、250、350クレジットです。伴奏を除去した後のクリアな歌声が3分未満だった場合や、学習に失敗した場合は、クレジットが自動で返金されます。
約15〜40分待つ。 学習は標準的なRVC v2の構成(48 kHz、RMVPEによるピッチ抽出)です。ページを閉じてもかまいません。
試聴して、使って、ダウンロードする。 学習が終わると、新しい声で歌った短いサンプルが届きます。その声は AIカバー曲ジェネレーター の「マイボイス」に追加され、.pthと.indexを含むzipとしてモデルをダウンロードし、他のRVCツールで使うこともできます。
学習は無料ではありません。レンタルしたGPU時間を使うため、毎回クレジットがかかります。その代わり、GPUもPythonもファイルの下準備も必要ありません。
RVCモデルのエポック数はいくつがいい?
確かめるために、同じ声で2回学習しました。素材は声質が安定したAIシンガー(私たちのバーチャルアーティストJUNO)で、それぞれのモデルで同じテスト曲を変換しました。
| テスト | 学習音声 | エポック数 | GPU時間 |
|---|---|---|---|
| 1回目 | 完成曲 約24分、伴奏あり | 100 | 約29分 |
| 2回目 | 約15分、先に歌声を分離 | 50 | 約9分 |
聴き比べると、100エポックのモデルのほうがわずかに似ていましたが、差は小さいものでした。そのため50エポックを標準にし、上位の品質は任意にしています。2回のテストは学習音声も異なり、1つの声で1回試しただけなので、法則ではなく参考データとして見てください。一般的には、エポックを増やすより学習音声をクリアにするほうが効果的で、データが少ないのにエポック数を極端に増やすと過学習することもあります。
RVCの.indexファイルに効果はある?
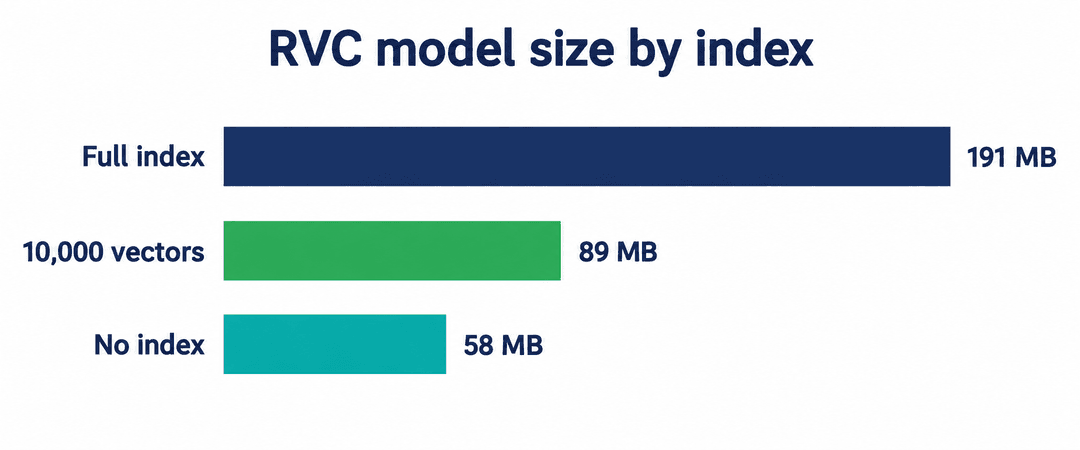
インデックスはRVCモデルの中で最も大きな部分なので、小さくできるか試しました。50エポックのモデルを使い、RVC自身が大きなデータセットで使うのと同じクラスタリング手法で、約45,000の特徴ベクトルを10,000個のクラスタ中心まで減らしてインデックスを作り直しました。
| バージョン | モデルzipのサイズ | 試聴テストの結果 |
|---|---|---|
| フルインデックス(45,162ベクトル) | 約191 MB | 基準 |
| 10,000ベクトルに縮小 | 約89 MB | 違いは聞き取れず |
| インデックスなし(.pthのみ) | 約58 MB | 違いは聞き取れず |
このテストでは、インデックスによる聞いてわかる差はありませんでした。10,000ベクトル版でindex rateを上げても、聞こえ方は変わりませんでした。ただし今回はクリアで安定したAI生成の声です。ノイズや揺らぎの多い人間の録音では結果が変わる可能性があるので、普遍的なルールとは考えないでください。RaoMusicでは折衷案として、学習したすべてのモデルに10,000ベクトルのインデックスを入れています。アップロードした音声の量にかかわらず、モデルは最大で約90 MBです。
RVC学習でよくある失敗
完成曲を伴奏ごと学習させる。 声と一緒にバンドの音まで学習してしまいます。
複数の歌手を混ぜる。 デュエット、ハモリ、フィーチャリングが入ると、声が全員の平均のようにぼやけます。
音域が狭すぎる。 静かで低いパートばかりだと、変換後の高音が苦しそうに聞こえます。
音声を直さずエポック数ばかり増やす。 ノイズの多い30分より、クリアな10分の歌声のほうが上です。エポックを増やしても悪いデータは直りません。
歌唱テクニックまで移せると思う。 RVCがコピーするのは声色で、歌のうまさではありません。カバーには元の歌手のビブラート、フェイク、歌い回しが残ります。
よくある質問
RVCモデルとは、Retrieval-based Voice Conversionで作るAIボイスモデルです。既存の録音の声を、学習した声に変換します。歌詞・メロディ・タイミングはそのまま残ります。通常は.pthの重みファイルと、任意の.indexファイルで構成されます。
.indexファイルには学習用録音の特徴量が保存されています。変換時にRVCはその中から最も近い音を探し、出力をそちらに寄せるため、ターゲットの声により近づくことがあります。.indexがなくても変換はできます。
RVCのソフトは無料のオープンソースなので、十分な性能のNVIDIA GPUがあればローカル学習は無料です。Colabノートブックなどの無料オンライン手段は制限があり、切断されたり動かなくなったりすることがあります。安定したオンライン学習ツールはGPU時間に応じて料金がかかります。RaoMusicでは学習1回ごとにクレジットを消費し、学習に失敗した場合は自動で返金されます。
多くの環境では、1人の声のクリアな音声が5〜15分ほどあれば学習できます。RaoMusicでは、伴奏を除去した後に少なくとも3分のクリアな歌声が残るよう、8〜15分のアップロードをお願いしています。
正解はひとつではありません。私たちのテストでは、同じ声で100エポックは50エポックよりわずかに良い程度だったので、まずは50エポックから始めるのが妥当です。エポックを増やすより、学習音声をクリアにするほうが効果的なことがほとんどです。
たいていは使えます。学習した声は、RVC v2(48 kHz)の.pthファイルと.indexファイルを含むzipとしてダウンロードでき、多くのRVC v2ボイスチェンジャーで読み込めます。互換性は相手のツールのバージョンや設定によるので、本格的に使う前にそちらで試してください。
RVC v2はv1より豊かな特徴量を入力音声から抽出するため、特に歌声でよりクリアで自然な結果になりやすいです。2つのバージョンのモデルに互換性はなく、現在のツールのほとんどはv2を前提としています。
自分の声でモデルを学習するのは問題ありません。他人の声を無断でクローンすると、パブリシティ権、本人の同意、プラットフォームの規約に関わる問題が生じる可能性があり、それを使った曲を公開すれば著作権の問題も加わります。クローンするのは、自分の声か使用許可を得た声だけにしてください。