
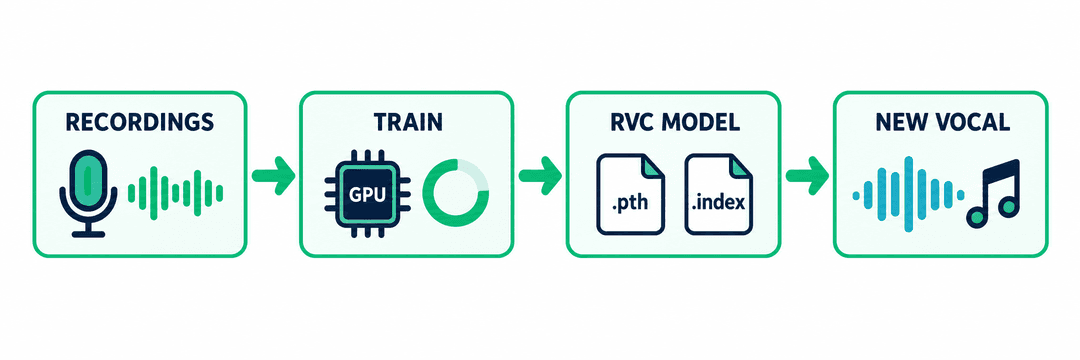
Resposta curta: um modelo RVC é um pequeno modelo de voz por IA criado com Retrieval-based Voice Conversion (RVC), um método de código aberto que troca a voz de uma gravação mantendo a letra, a melodia e o ritmo. Um modelo RVC treinado costuma vir em dois arquivos: um .pth com os pesos da voz e um .index opcional, que ajuda o resultado a soar mais parecido com o cantor ou locutor original. Você treina um a partir de poucos minutos de gravações limpas de uma única voz.
Na música feita com IA, "RVC" quase sempre se refere a esse modelo de conversão de voz, e "clonagem de voz com RVC" significa treinar um modelo com uma voz específica. Boa parte dos covers com IA que circulam na internet foi feita com ele.
O que significa RVC?
RVC é a sigla de Retrieval-based Voice Conversion (conversão de voz baseada em recuperação). O RVC-Project lançou o método publicamente em 2023, sob licença MIT. Ele virou um dos fluxos de conversão de voz de código aberto mais usados porque roda em placas de vídeo NVIDIA comuns e muitas vezes precisa de menos áudio de treino do que abordagens mais antigas.
O ponto central é a "conversão de voz". O RVC não escreve letras nem compõe músicas. Ele pega uma interpretação vocal que já existe e troca a voz: o fraseado, a afinação e o ritmo do cantor original continuam, e o timbre passa a ser o da voz usada no treino do modelo.
O que é um conversor de voz RVC e como ele funciona?
Um conversor de voz RVC é qualquer ferramenta que carrega um modelo RVC e passa uma gravação por ele. Em termos simples, ele faz três coisas com cada vocal que converte:
Separa o que é cantado de quem canta. Um modelo de fala (HuBERT / ContentVec) transforma o vocal de entrada em características que descrevem os sons produzidos, em grande parte independentes da identidade do cantor.
Acompanha a afinação. Um extrator de pitch (RMVPE é o mais comum; Crepe e Harvest são alternativas) segue a melodia para que a voz convertida cante as mesmas notas. Dá para subir ou descer uma oitava na conversão de voz masculina para feminina, ou o contrário.
Reconstrói o áudio na voz de destino. O gerador treinado transforma essas características e essa afinação de volta em som, com o timbre da voz de destino.
O "retrieval" (recuperação) do nome é a etapa extra e opcional no meio do caminho: antes de reconstruir o áudio, o RVC busca os sons mais parecidos nas gravações de treino (guardados no arquivo .index) e aproxima as características deles. Isso pode deixar o resultado mais próximo de como a voz de destino soa de verdade.
A conversão é uma aproximação forte, não uma cópia perfeita: dependendo do vocal de origem e do modelo, ainda dá para ouvir oscilações de afinação, consoantes emboladas ou ruídos de respiração.
O que são os arquivos .pth e .index de um modelo RVC?
Quando alguém compartilha ou vende "um modelo RVC", está falando destes arquivos, normalmente dentro de um único zip:
| Arquivo | O que é | Tamanho típico (RVC v2) | Obrigatório? |
|---|---|---|---|
| .pth | Os pesos treinados da voz: a parte que de fato "é" a voz | Em geral cerca de 55 MB | Sim |
| .index | Um índice pesquisável de características do áudio de treino, usado na recuperação | De cerca de 15 MB a várias centenas de MB | Não, mas costuma vir junto |
Os tamanhos exatos variam conforme a taxa de amostragem, a ferramenta de treino e quantos vetores de características o índice guarda. O arquivo .index é opcional. Sem ele, a conversão funciona normalmente usando só o .pth. Com ele, um ajuste chamado "index rate" controla o quanto o resultado é puxado para a voz do treino. Aumentar esse valor pode deixar o resultado mais parecido, mas também pode trazer artefatos abafados ou metálicos, principalmente se o áudio de treino tinha ruído. Por isso é questão de equilíbrio, não de "quanto mais, melhor".
O índice pode ser bem maior do que os pesos. No nosso próprio teste, treinar com cerca de 15 minutos de vocais separados gerou um índice de 136 MB ao lado de um .pth de 55 MB, além de um arquivo de trabalho total_fea.npy de 132 MB que os scripts de treino deixam para trás e que a inferência nunca usa.
Qual é a diferença entre RVC v1 e RVC v2?
O RVC v2 é a versão que quase todo mundo usa hoje. Ele extrai características mais ricas, de 768 dimensões, do áudio de entrada (o v1 usava 256), o que em geral dá resultados mais claros e naturais, principalmente no canto. Os modelos são treinados em 32, 40 ou 48 kHz; 48 kHz é a escolha mais comum para música.
Modelos v1 e v2 não são intercambiáveis. As ferramentas de conversão precisam saber de qual versão é um arquivo .pth, e a maioria das ferramentas com manutenção ativa é feita em torno do v2.
De onde vêm os modelos RVC?
Existem duas origens:
Modelos compartilhados. Sites e repositórios da comunidade hospedam milhares de modelos RVC, muitos deles imitando cantores, atores ou personagens reais. A maioria é publicada sem a permissão do dono da voz, as licenças costumam ser pouco claras e alguns arquivos são checkpoints de treino, não modelos prontos para inferência. Use com cautela, principalmente em qualquer coisa que você pretenda publicar.
Modelos que você mesmo treina. Treinar com a sua própria voz, ou com uma voz que você tem permissão clara para usar, evita esses problemas. Também é o único jeito de ter um modelo de uma voz que ninguém publicou.
Se você quer cantar covers com a voz de outra pessoa, nosso guia para fazer um cover com IA de forma legal aborda com mais detalhes as questões de consentimento e direitos autorais.
Como treinar um modelo RVC?
Todo treino de RVC segue as mesmas etapas:
Reúna áudio limpo de uma única voz. Algo entre 5 e 15 minutos de canto (ou fala) costuma funcionar. Variedade (notas graves, médias e agudas) importa mais do que mais minutos.
Remova tudo o que não for a voz. Instrumental, reverb, harmonias e outros cantores acabam sendo aprendidos como parte da voz. Um removedor de vocais ajuda quando você só tem músicas prontas.
Corte e pré-processe. O áudio é dividido em trechos curtos, os silêncios são descartados e a afinação e as características são extraídas.
Treine por um número definido de epochs. Um epoch é uma passada completa pelo áudio de treino. Mais epochs levam mais tempo e trazem ganhos cada vez menores.
Gere o índice e exporte. O resultado é o arquivo .pth mais o arquivo .index.
Onde dá para rodar?
| Opção | O que você precisa | Indicado para | Pontos de atenção |
|---|---|---|---|
| RVC WebUI local (ou forks como o Applio) | Uma GPU NVIDIA recente, ambiente Python, espaço em disco | Controle total, sem custo por treino | Tempo de configuração, problemas de driver, ajustar dezenas de parâmetros |
| Notebooks do Google Colab | Uma conta Google, muitas vezes um plano pago para ter GPU estável | Quem não tem GPU local | Sessões caem; mudanças nos notebooks e nas políticas quebram tudo; confira os termos atuais do Colab |
| APIs para desenvolvedores (por exemplo, o train-rvc-model do Replicate) | Uma conta na API e um jeito de empacotar o zip do dataset | Integrar o treino ao seu próprio app | Você cuida sozinho da preparação dos arquivos, dos webhooks e do armazenamento |
| Serviços pagos de treino | O tempo de outra pessoa | Modelos avulsos | Prazo de entrega, privacidade das suas gravações, qualidade variável |
| Treinadores online como o RaoMusic | Um navegador e suas gravações | Treinar sem GPU nem configuração e usar a voz na hora | Cada treino custa créditos |
Dá para treinar um modelo RVC online de graça?
Em parte. O software RVC é gratuito e de código aberto, então treinar no seu próprio computador não custa nada além do hardware e da energia, desde que você tenha uma GPU NVIDIA capaz. As opções online gratuitas são menos confiáveis: o tempo de GPU grátis do Colab é limitado e as sessões podem cair no meio do treino, os notebooks da comunidade quebram quando as dependências mudam, e os planos gratuitos de APIs de treino (quando existem) têm cotas. O treino exige tempo de GPU, por isso os treinadores online estáveis, incluindo o RaoMusic, cobram por ele. Se o mais importante é ser "grátis", o treino local é o caminho realista; se você não tem GPU ou não quer configurar nada, um treinador online economiza esse tempo.
Como treinar um modelo de voz RVC online com o RaoMusic
A Clonagem de voz com IA do RaoMusic executa todo o processo acima no navegador:
Adicione de 8 a 15 minutos do seu próprio canto. Envie arquivos ou escolha músicas da sua biblioteca. O instrumental é removido automaticamente e os silêncios são cortados.
Escolha a qualidade do treino. Padrão (50 epochs), Alta (100) ou Máxima (150), por 150, 250 ou 350 créditos. Se sobrarem menos de 3 minutos de canto nítido depois da separação, ou se o treino falhar, os créditos são reembolsados automaticamente.
Aguarde cerca de 15 a 40 minutos. O treino usa uma configuração padrão de RVC v2: 48 kHz com extração de pitch RMVPE. Você pode fechar a página.
Ouça, use e baixe. Ao terminar, um trecho curto é cantado com a sua nova voz. A voz passa a aparecer em "Minhas vozes" no Gerador de covers com IA, e você pode baixar o modelo como um zip com os arquivos .pth e .index para usar em outras ferramentas RVC.
O treino não é gratuito: cada execução custa créditos, porque usa tempo de GPU alugado. Em troca, você não precisa de GPU, de Python nem de preparar arquivos.
Quantos epochs usar para treinar um modelo RVC?
Treinamos a mesma voz duas vezes para descobrir. A fonte foi uma cantora gerada por IA com voz consistente (nossa artista virtual JUNO), e convertemos a mesma música de teste com cada modelo:
| Teste | Áudio de treino | Epochs | Tempo de GPU |
|---|---|---|---|
| Treino 1 | Cerca de 24 minutos de músicas completas, com o instrumental | 100 | Cerca de 29 minutos |
| Treino 2 | Cerca de 15 minutos, com os vocais separados antes | 50 | Cerca de 9 minutos |
Ouvindo lado a lado, o modelo de 100 epochs soou um pouco mais parecido, mas a diferença foi pequena. É por isso que 50 epochs é o nosso padrão e os níveis mais altos são opcionais. Os dois treinos também usaram áudios de treino diferentes, e este é um único teste com uma única voz, então encare como um dado, não como regra. Em geral, um áudio de treino limpo importa mais do que epochs extras, e números muito altos de epochs podem causar overfitting em um dataset pequeno.
O arquivo .index do RVC faz diferença?
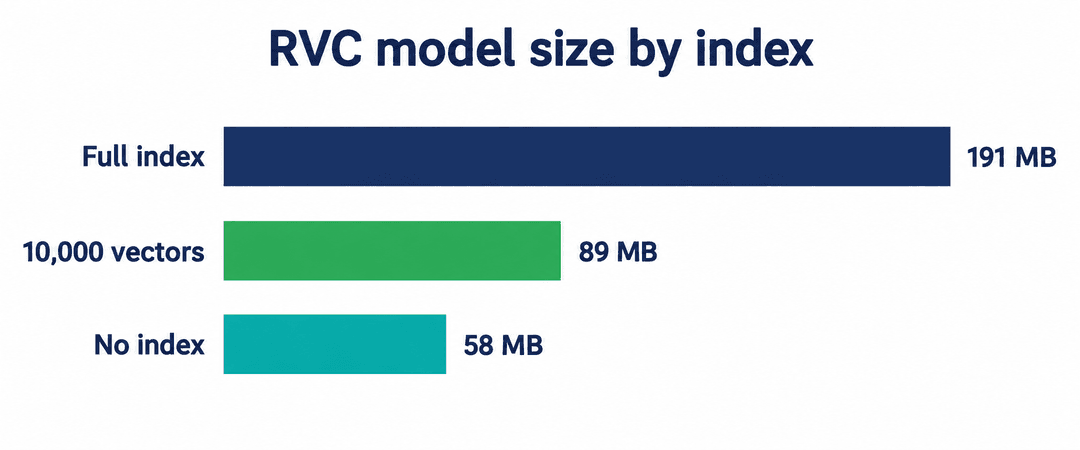
O índice é a maior parte de um modelo RVC, então testamos se dá para encolhê-lo. Com o modelo de 50 epochs, reconstruímos o índice de cerca de 45 mil vetores de características para 10 mil centros de cluster, usando a mesma técnica de agrupamento que o próprio RVC usa em datasets grandes:
| Versão | Tamanho do zip do modelo | Resultado no nosso teste de audição |
|---|---|---|
| Índice completo (45.162 vetores) | Cerca de 191 MB | Referência |
| Índice reduzido para 10.000 vetores | Cerca de 89 MB | Não ouvimos diferença |
| Sem índice (só o .pth) | Cerca de 58 MB | Não ouvimos diferença |
Neste teste, o índice não fez diferença audível clara, e aumentar o index rate na versão de 10.000 vetores também não mudou o que ouvimos. Era uma voz gerada por IA, limpa e consistente; gravações humanas, com mais ruído e variação, podem se comportar de outro jeito, então não trate isso como regra universal. O RaoMusic mantém um índice de 10.000 vetores em todo modelo treinado como meio-termo: no máximo cerca de 90 MB, não importa quanto áudio você envie.
Erros comuns no treino de RVC
Treinar com músicas prontas sem tirar o instrumental. O modelo aprende a banda junto com a voz.
Misturar vários cantores. Duetos, harmonias e participações especiais embaralham a voz em uma média de todo mundo.
Pouca extensão vocal. Se todos os trechos forem baixos e graves, as notas agudas vão soar forçadas depois da conversão.
Correr atrás de epochs em vez de corrigir o áudio. Dez minutos de vocais limpos valem mais do que trinta minutos de vocais com ruído, e mais epochs não consertam dados ruins.
Esperar um transplante de técnica. O RVC copia o timbre, não a habilidade. Um cover mantém o vibrato, os melismas e o fraseado do cantor original.
Perguntas frequentes
Um modelo RVC é um modelo de voz por IA criado com Retrieval-based Voice Conversion. Ele transforma a voz de uma gravação existente na voz com que foi treinado, mantendo a letra, a melodia e o ritmo. Normalmente é formado por um arquivo de pesos .pth e um arquivo .index opcional.
O arquivo .index guarda características das gravações de treino. Durante a conversão, o RVC busca nele os sons mais parecidos e aproxima o resultado deles, o que pode deixar a voz mais próxima da voz de destino. A conversão funciona mesmo sem ele.
O software RVC é gratuito e de código aberto, então o treino local sai de graça se você tiver uma GPU NVIDIA capaz. As opções online gratuitas, como os notebooks do Colab, são limitadas e podem desconectar ou parar de funcionar. Treinadores online estáveis cobram pelo tempo de GPU; no RaoMusic, cada treino custa créditos, com reembolso automático se o treino falhar.
A maioria das configurações funciona com cerca de 5 a 15 minutos de áudio limpo de uma única voz. O RaoMusic pede de 8 a 15 minutos de envios para que reste pelo menos 3 minutos de canto nítido depois que o instrumental é removido.
Não existe um número único certo. No nosso teste, 100 epochs soaram só um pouco melhor do que 50 com a mesma voz, então 50 é um bom ponto de partida. Um áudio de treino mais limpo costuma ajudar mais do que mais epochs.
Na maioria dos casos, sim. As vozes treinadas são baixadas como um zip com um arquivo .pth RVC v2 (48 kHz) e um arquivo .index, que abrem na maioria dos conversores de voz RVC v2. A compatibilidade depende da versão e das configurações da outra ferramenta, então teste antes de depender dela.
O RVC v2 extrai características mais ricas do áudio de entrada do que o v1, o que costuma dar resultados mais claros e naturais, principalmente no canto. As duas versões não são intercambiáveis, e a maioria das ferramentas atuais espera o v2.
Treinar um modelo com a sua própria voz não tem problema. Clonar a voz de outra pessoa sem permissão pode gerar problemas de direito de imagem e de voz, de consentimento e de regras das plataformas, e publicar músicas feitas com ele acrescenta questões de direitos autorais. Só clone vozes que são suas ou que você tem permissão para usar.