
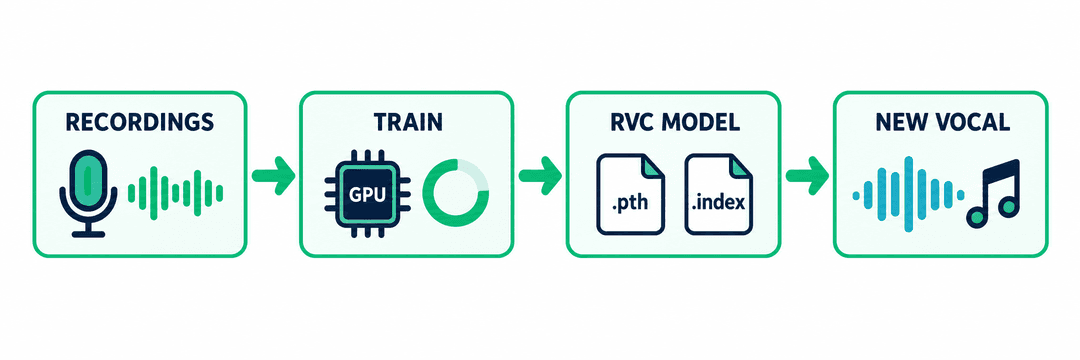
简短回答: RVC 模型是用 RVC(Retrieval-based Voice Conversion,检索式声音转换)做出来的小型 AI 声音模型。RVC 是一种开源方法,能把录音里的人声换成另一个声音,同时保留歌词、旋律和节奏。训练好的 RVC 模型通常是两个文件:存放声音权重的 .pth 文件,以及一个可选的 .index 文件,用来让输出更接近原声。你只需要同一个人几分钟的干净录音就能训练一个。
在 AI 音乐圈,「RVC」几乎都指这种声音转换模型,「RVC 声音克隆」就是用某个人的声音训练一个这样的模型。网上流传的 AI 翻唱,很大一部分都是用它做的。
RVC 是什么的缩写?
RVC 是 Retrieval-based Voice Conversion(检索式声音转换) 的缩写。RVC-Project 在 2023 年以 MIT 协议公开发布了它。它能在普通的 NVIDIA 显卡上运行,需要的训练音频往往也比更早的方法少,所以成了使用最广的开源声音转换方案之一。
关键在「声音转换」:RVC 不写歌词,也不作曲。它拿一段现成的演唱重新「换声」:原唱的咬字、音高和节奏都保留,音色变成模型训练时用的那个声音。
RVC 变声器是什么?它怎么工作?
RVC 变声器就是任何能加载 RVC 模型、把录音过一遍的工具。简单说,它对每段人声做三件事:
把「唱了什么」和「谁在唱」分开。 一个语音模型(HuBERT / ContentVec)把输入的人声转成描述发音内容的特征,这些特征基本不带歌手本人的音色。
跟踪音高。 音高提取器(常用 RMVPE,也有 Crepe、Harvest 等)跟住旋律,让换出来的声音唱在同样的音上。男声转女声、女声转男声时可以整体升降一个八度。
用目标音色把声音重建出来。 训练好的生成器把特征和音高还原成声音,用的是目标歌手的音色。
名字里的「检索」是中间一个可选步骤:重建之前,RVC 会在训练录音里(存在 .index 文件中)找最相似的发音,把特征往那边拉一点,让输出更接近目标声音的真实质感。
换声是很接近的模仿,但不是完美复制:根据原唱和模型的不同,仍可能听到音高抖动、辅音含糊或气声杂音。
RVC 模型里的 .pth 和 .index 文件是什么?
大家分享或出售的「一个 RVC 模型」,指的就是这几个文件,通常打包在一个 zip 里:
| 文件 | 是什么 | 常见大小(RVC v2) | 必须吗? |
|---|---|---|---|
| .pth | 训练好的声音权重,真正「就是」这个声音的部分 | 常见约 55 MB | 必须 |
| .index | 训练音频特征的检索索引,用于「检索」那一步 | 约 15 MB 到几百 MB 不等 | 可选,但通常会附带 |
具体大小随采样率、训练工具和索引保留的特征数量而变。.index 文件是可选的:没有它,换声照样能做,只用 .pth。有了它,可以用「索引比例(index rate)」控制输出往训练音色靠多少。调高能更像,但也可能带来发闷或发尖的杂音,训练音频有噪声时尤其明显,所以要找平衡,不是越高越好。
索引可能比权重大得多。我们自己的测试里,用约 15 分钟分离后的人声训练,得到了 136 MB 的索引和 55 MB 的 .pth,外加一个 132 MB 的 total_fea.npy 中间文件,这是训练脚本留下的,换声时根本用不到。
RVC v1 和 RVC v2 有什么区别?
现在几乎都用 RVC v2。它从输入里提取的特征更丰富(768 维,v1 是 256 维),效果通常更清晰自然,唱歌时尤其明显。模型可以用 32、40 或 48 kHz 训练,做音乐一般选 48 kHz。
v1 和 v2 的模型不能互换。变声工具需要知道一个 .pth 是哪个版本,目前还在维护的工具大多围绕 v2 开发。
RVC 模型从哪里来?
有两个来源:
别人分享的模型。 社区网站和模型仓库里有成千上万个 RVC 模型,很多是在模仿真实歌手、演员或角色。大多数没有经过声音主人同意,授权往往不清楚,有些文件甚至是训练中途的存档而不是能直接用的推理模型。用的时候要谨慎,打算公开发布的作品更要小心。
自己训练的模型。 用你自己的声音,或你明确获得授权的声音来训练,就没有这些问题。想要一个没人公开过的声音,也只能自己训练。
如果你想用别人的声音唱翻唱,我们的合法制作 AI 翻唱指南更详细地讲了授权和版权问题。
怎么训练 RVC 模型?
各种 RVC 训练方式的步骤都一样:
收集同一个人的干净音频。 一般 5 到 15 分钟的演唱(或说话)就够。音域覆盖广(低、中、高音都有)比时长更长更重要。
去掉人声以外的一切。 伴奏、混响、和声、其他歌手都会被当成声音的一部分学进去。手里只有成品歌的话,可以先用人声分离工具处理。
切片和预处理。 音频被切成短片段,去掉静音,提取音高和特征。
按设定的轮数(epoch)训练。 一轮就是把训练音频完整过一遍。轮数越多越耗时,收益也越来越小。
建索引并导出。 最后得到 .pth 文件和 .index 文件。
在哪里训练?
| 方式 | 需要什么 | 适合 | 注意 |
|---|---|---|---|
| 本地 RVC WebUI(或 Applio 等分支) | 较新的 NVIDIA 显卡、Python 环境、硬盘空间 | 完全可控,每次训练不花钱 | 安装费时、驱动问题、几十个参数要调 |
| Google Colab 笔记本 | Google 账号,想要稳定的 GPU 往往得付费 | 没有本地显卡 | 会话会断开,笔记本和政策一变就跑不了,留意 Colab 当前条款 |
| 开发者 API(比如 Replicate 的 train-rvc-model) | API 账号,自己打包数据集 zip | 把训练集成进自己的应用 | 文件准备、回调、存储都要自己处理 |
| 付费代训练服务 | 别人的时间 | 一次性做个模型 | 周期长,录音隐私,质量参差 |
| RaoMusic 这类在线训练工具 | 浏览器和你的录音 | 不想装环境、没有显卡,训完马上就能用 | 每次训练要花积分 |
能免费在线训练 RVC 模型吗?
部分可以。RVC 软件本身免费开源,如果你有一块够用的 NVIDIA 显卡,在自己电脑上训练除了硬件和电费不花钱。免费的在线方案就没那么靠得住:Colab 免费 GPU 时长有限,训练到一半可能断开;社区笔记本在依赖更新后经常跑不起来;训练 API 即使有免费额度也有配额。训练要占用 GPU,所以稳定的在线训练工具(包括 RaoMusic)都会收费。最在意「免费」的话,本地训练是更现实的路;没有显卡或不想折腾环境,在线训练能省下这些时间。
用 RaoMusic 在线训练 RVC 声音模型
RaoMusic 的 AI 声音克隆在浏览器里就能跑完上面整个流程:
添加 8–15 分钟你自己唱的音频。 可以上传文件,也可以从歌库里选。伴奏会自动去除,静音会被剪掉。
选训练质量。 标准(50 轮)、高(100 轮)、极致(150 轮),分别 150、250、350 积分。去除伴奏后清晰歌声不足 3 分钟,或训练失败,积分会自动退还。
等待约 15–40 分钟。 训练用的是标准的 RVC v2 配置:48 kHz、RMVPE 音高提取。可以关掉页面。
试听、使用、下载。 训练完成后,会先用你的新音色唱一小段让你试听。之后这个音色会出现在 AI 翻唱生成器的「我的音色」里;你也可以把模型下载成包含 .pth 和 .index 的 zip,在其他 RVC 工具里使用。
训练不是免费的:每次训练都要花积分,因为要租用 GPU 时间。换来的是不需要显卡、不用装 Python、不用自己准备文件。
RVC 模型训练多少轮合适?
我们用同一个声音训练了两次来看看。素材是一位音色稳定的 AI 歌手(我们的虚拟歌手 JUNO),再用两个模型分别翻唱同一首测试歌:
| 测试 | 训练音频 | 轮数 | GPU 时间 |
|---|---|---|---|
| 第 1 次 | 约 24 分钟完整歌曲,没去伴奏 | 100 | 约 29 分钟 |
| 第 2 次 | 约 15 分钟,先分离出人声 | 50 | 约 9 分钟 |
对比试听时,100 轮的模型听起来稍微更像一点,但差别很小。所以我们默认用 50 轮,更高的档位作为可选。两次测试的训练音频也不一样,而且只是一个声音的一次测试,请把它当作一个参考数据,而不是规律。一般来说,训练音频干净比多训几轮更重要;数据少的时候,轮数太多还可能过拟合。
RVC 的 .index 文件到底有没有用?
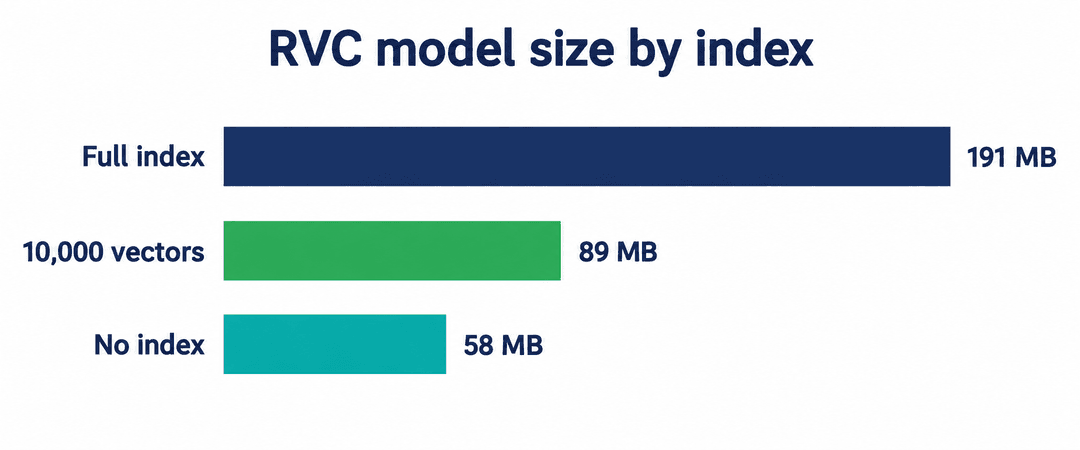
索引是 RVC 模型里最大的部分,所以我们测试了能不能把它压小。用 50 轮的那个模型,我们把索引从约 4.5 万条特征向量聚类压缩到 1 万个中心点,用的就是 RVC 自己处理大数据集时的聚类方法:
| 版本 | 模型 zip 大小 | 我们的试听结果 |
|---|---|---|
| 完整索引(45,162 条) | 约 191 MB | 参照 |
| 索引压到 1 万条 | 约 89 MB | 听不出区别 |
| 不带索引(只有 .pth) | 约 58 MB | 听不出区别 |
这次测试里,索引没有带来明显可听的差别;把 1 万条版本的索引比例调高,我们也没听出变化。不过这是一个干净、稳定的 AI 生成声音,噪声更多、变化更大的真人录音结果可能不同,别把它当成普遍规律。RaoMusic 在每个训练好的模型里都保留一个 1 万条的索引,作为折中:不管上传多少音频,模型最多约 90 MB。
训练 RVC 模型的常见错误
拿成品歌直接训练,没去伴奏。 模型会把乐队也当成声音学进去。
混入多个歌手。 合唱、和声、featuring 会让声音变成所有人的平均。
音域太窄。 素材全是又轻又低的片段,换声后高音会显得吃力。
只顾加轮数,不改素材。 10 分钟干净人声胜过 30 分钟嘈杂人声,轮数补不了坏数据。
以为能把唱功也换过来。 RVC 复制的是音色,不是技巧。翻唱会保留原唱的颤音、转音和咬字。
常见问题
RVC 模型是用检索式声音转换(Retrieval-based Voice Conversion)做的 AI 声音模型。它能把现成录音里的人声换成训练时用的那个声音,同时保留歌词、旋律和节奏。通常由一个 .pth 权重文件和一个可选的 .index 文件组成。
.index 文件存着训练录音的特征。换声时,RVC 会在里面找最接近的发音,把输出往那边拉,让结果更像目标声音。没有它也能正常换声。
RVC 软件免费开源,如果你有够用的 NVIDIA 显卡,本地训练是免费的。Colab 笔记本这类免费在线方案时长有限,还可能断开或跑不起来。稳定的在线训练工具会按 GPU 时间收费;在 RaoMusic,每次训练花积分,训练失败会自动退还。
大多数情况下,同一个人约 5 到 15 分钟的干净音频就够。RaoMusic 要求上传 8 到 15 分钟,保证去除伴奏后至少还有 3 分钟清晰歌声。
没有统一答案。我们的测试里,同一个声音 100 轮只比 50 轮稍好一点,所以 50 轮是个合理的起点。训练音频干净通常比多训几轮更有用。
一般可以。训练好的音色可以下载成 zip,里面是 RVC v2(48 kHz)的 .pth 文件和 .index 文件,大多数 RVC v2 变声器都能加载。兼容性取决于对方工具的版本和设置,正式使用前先在那边测一下。
RVC v2 从输入音频里提取的特征比 v1 更丰富,效果通常更清晰自然,唱歌时尤其明显。两个版本的模型不能互换,目前大多数工具都要求 v2。
用你自己的声音训练没有问题。未经许可克隆别人的声音,可能涉及肖像权(声音权)、授权同意和平台规则的问题;用它发布歌曲,还会牵涉版权。只克隆你自己的、或已获授权的声音。