
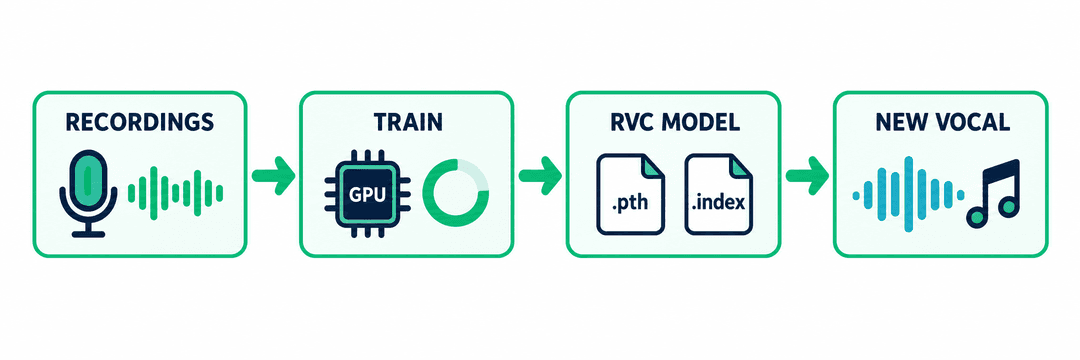
한 줄 요약: RVC 모델은 RVC(Retrieval-based Voice Conversion)로 만든 작은 AI 보이스 모델입니다. RVC는 녹음 속 목소리를 다른 목소리로 바꾸면서 가사, 멜로디, 타이밍은 그대로 유지하는 오픈소스 기술입니다. 학습이 끝난 RVC 모델은 보통 두 개의 파일로 이루어집니다. 목소리 가중치가 담긴 .pth 파일, 그리고 원래 화자나 가수의 목소리에 더 가깝게 만들어 주는 선택 사항인 .index 파일입니다. 한 사람의 깨끗한 녹음 몇 분만 있으면 학습할 수 있습니다.
AI 음악에서 "RVC"라고 하면 거의 항상 이 음성 변환 모델을 뜻하고, "RVC 보이스 클로닝"은 특정 목소리로 이 모델을 학습시키는 것을 말합니다. 온라인에 공유되는 AI 커버곡 상당수가 RVC로 만들어졌습니다.
RVC는 무엇의 약자인가요?
RVC는 Retrieval-based Voice Conversion(검색 기반 음성 변환) 의 약자입니다. RVC-Project가 2023년 MIT 라이선스로 공개했습니다. 일반 소비자용 NVIDIA 그래픽카드에서 돌아가고, 기존 방식보다 적은 학습 오디오로도 충분한 경우가 많아 가장 널리 쓰이는 오픈소스 음성 변환 워크플로 중 하나가 되었습니다.
핵심은 "음성 변환"입니다. RVC는 가사를 쓰거나 곡을 만들지 않습니다. 이미 있는 노래를 다른 목소리로 다시 입히는 것으로, 원래 가수의 표현, 음정, 리듬은 그대로 두고 음색만 학습된 목소리로 바뀝니다.
RVC 보이스 체인저란? 어떻게 작동하나요?
RVC 보이스 체인저는 RVC 모델을 불러와 녹음을 변환하는 모든 도구를 말합니다. 쉽게 말해, 변환하는 보컬마다 세 가지 작업을 합니다.
"무엇을 부르는지"와 "누가 부르는지"를 분리합니다. 음성 모델(HuBERT / ContentVec)이 입력된 보컬을 발음 내용을 나타내는 특징으로 바꿉니다. 이 특징에는 가수 본인의 음색이 거의 담기지 않습니다.
음정을 따라갑니다. 피치 추출기(주로 RMVPE를 쓰며 Crepe, Harvest도 선택 가능)가 멜로디를 따라가 변환된 목소리가 같은 음을 내도록 합니다. 남성 목소리를 여성으로, 여성을 남성으로 바꿀 때는 한 옥타브 올리거나 내릴 수 있습니다.
목표 목소리로 오디오를 다시 만듭니다. 학습된 생성기가 특징과 음정을 목표 화자의 음색으로 다시 소리로 바꿉니다.
이름에 있는 "Retrieval(검색)"은 중간에 들어가는 선택 단계입니다. 소리를 다시 만들기 전에 RVC가 학습 녹음(.index 파일에 저장된 것)에서 가장 비슷한 소리를 찾아 특징을 그쪽으로 조금 끌어당깁니다. 이렇게 하면 목표 목소리의 실제 느낌에 더 가까워질 수 있습니다.
변환은 꽤 정교한 근사치일 뿐 완벽한 복제는 아닙니다. 원본 보컬과 모델에 따라 음정 흔들림, 뭉개진 자음, 숨소리 같은 잡음이 들릴 수 있습니다.
RVC 모델의 .pth와 .index 파일은 무엇인가요?
사람들이 "RVC 모델"을 공유하거나 판매할 때는 다음 파일을 말하며, 보통 zip 하나에 묶여 있습니다.
| 파일 | 무엇인가 | 일반적인 크기(RVC v2) | 필수인가요? |
|---|---|---|---|
| .pth | 학습된 목소리 가중치. 실제로 "목소리 그 자체"인 부분 | 보통 약 55 MB | 필수 |
| .index | 학습 오디오의 특징을 검색할 수 있는 인덱스. 검색 단계에 사용 | 약 15 MB부터 수백 MB까지 | 선택이지만 대부분 함께 제공 |
정확한 크기는 샘플레이트, 학습 도구, 인덱스에 남기는 특징 벡터 수에 따라 달라집니다. .index 파일은 선택 사항입니다. 없어도 변환은 되고, 이때는 .pth만 사용합니다. 있으면 "index rate" 설정으로 결과물을 학습된 목소리 쪽으로 얼마나 끌어당길지 조절할 수 있습니다. 값을 올리면 더 비슷해질 수 있지만 먹먹하거나 쨍한 잡음이 생길 수도 있고, 학습 오디오에 잡음이 많았다면 특히 그렇습니다. "높을수록 좋다"가 아니라 균형을 찾는 설정입니다.
인덱스는 가중치보다 훨씬 클 수 있습니다. 저희 테스트에서는 분리한 보컬 약 15분으로 학습했더니 .pth는 55 MB인데 인덱스는 136 MB였습니다. 여기에 학습 스크립트가 남기는 132 MB짜리 total_fea.npy 작업 파일도 생겼는데, 이 파일은 변환(추론) 때 전혀 쓰이지 않습니다.
RVC v1과 RVC v2의 차이는?
지금은 거의 모두가 RVC v2를 씁니다. v2는 입력에서 더 풍부한 768차원 특징을 추출하며(v1은 256차원), 특히 노래에서 대체로 더 선명하고 자연스러운 결과를 냅니다. 모델은 32, 40, 48 kHz로 학습할 수 있으며, 음악에는 보통 48 kHz를 씁니다.
v1 모델과 v2 모델은 서로 호환되지 않습니다. 변환 도구는 .pth 파일이 어느 버전인지 알아야 하고, 현재 활발히 관리되는 도구는 대부분 v2를 기준으로 만들어져 있습니다.
RVC 모델은 어디서 구하나요?
출처는 두 가지입니다.
공유된 모델. 커뮤니티 사이트와 저장소에는 수천 개의 RVC 모델이 있고, 그중 상당수는 실제 가수, 배우, 캐릭터의 목소리를 흉내 낸 것입니다. 대부분 목소리 주인의 허락 없이 올라와 있고, 라이선스가 불분명한 경우가 많으며, 바로 쓸 수 있는 추론 모델이 아니라 학습 중간 체크포인트인 파일도 있습니다. 특히 공개할 작업물에 쓸 생각이라면 신중하게 다루세요.
직접 학습한 모델. 내 목소리나 사용 허락을 명확히 받은 목소리로 학습하면 이런 문제를 피할 수 있습니다. 아무도 공개하지 않은 목소리의 모델을 얻는 방법도 이것뿐입니다.
다른 사람의 목소리로 커버곡을 부르게 하고 싶다면, AI 커버곡을 합법적으로 만드는 가이드에서 동의와 저작권 문제를 더 자세히 다룹니다.
RVC 모델은 어떻게 학습하나요?
어떤 RVC 학습 환경이든 단계는 같습니다.
한 사람의 깨끗한 오디오를 모읍니다. 노래(또는 말소리) 5~15분 정도면 대개 충분합니다. 시간을 늘리는 것보다 저음, 중음, 고음을 고루 담는 것이 더 중요합니다.
목소리가 아닌 소리를 모두 없앱니다. 반주, 리버브, 화음, 다른 가수의 목소리는 모두 목소리의 일부로 학습됩니다. 완성된 곡밖에 없다면 보컬 제거기가 도움이 됩니다.
자르고 전처리합니다. 오디오를 짧은 구간으로 자르고, 무음을 빼고, 음정과 특징을 추출합니다.
정해진 에포크 수만큼 학습합니다. 1에포크는 학습 오디오를 한 바퀴 도는 것입니다. 에포크가 많을수록 오래 걸리고, 효과는 점점 줄어듭니다.
인덱스를 만들고 내보냅니다. 결과물은 .pth 파일과 .index 파일입니다.
어디서 학습할 수 있나요?
| 방법 | 필요한 것 | 적합한 경우 | 주의할 점 |
|---|---|---|---|
| 로컬 RVC WebUI(또는 Applio 같은 파생 버전) | 최신 NVIDIA GPU, Python 환경, 디스크 공간 | 완전한 제어, 학습할 때마다 드는 비용 없음 | 설치 시간, 드라이버 문제, 수십 가지 설정 조정 |
| Google Colab 노트북 | Google 계정, 안정적인 GPU를 쓰려면 유료 요금제가 필요한 경우가 많음 | 로컬 GPU가 없을 때 | 세션이 끊기고, 노트북이나 정책이 바뀌면 작동하지 않음. Colab 최신 약관 확인 필요 |
| 개발자 API(예: Replicate의 train-rvc-model) | API 계정과 데이터셋 zip을 묶을 방법 | 내 앱에 학습 기능을 넣을 때 | 파일 준비, 웹훅, 저장소를 직접 처리해야 함 |
| 유료 학습 대행 서비스 | 다른 사람의 시간 | 일회성 모델 제작 | 소요 시간, 녹음 파일의 개인정보, 들쭉날쭉한 품질 |
| RaoMusic 같은 온라인 학습 도구 | 브라우저와 내 녹음 | GPU나 설치 없이 학습하고 바로 그 목소리를 쓰고 싶을 때 | 학습할 때마다 크레딧 소모 |
RVC 모델을 무료로 온라인 학습할 수 있나요?
일부는 가능합니다. RVC 소프트웨어 자체는 무료 오픈소스라서, 성능이 충분한 NVIDIA GPU가 있다면 내 컴퓨터에서 학습하는 데 드는 비용은 하드웨어와 전기료뿐입니다. 무료 온라인 방법은 그보다 믿기 어렵습니다. Colab 무료 GPU 시간은 제한이 있어 학습 도중 세션이 끊길 수 있고, 커뮤니티 노트북은 의존성이 바뀌면 작동하지 않으며, 학습 API의 무료 등급(있는 경우)에도 사용량 한도가 있습니다. 학습에는 GPU 시간이 들기 때문에 RaoMusic을 포함한 안정적인 온라인 학습 도구는 비용을 받습니다. "무료"가 가장 중요하다면 로컬 학습이 현실적인 선택이고, GPU가 없거나 설치가 번거롭다면 온라인 학습 도구로 그 시간을 아낄 수 있습니다.
RaoMusic으로 RVC 보이스 모델을 온라인 학습하는 방법
RaoMusic의 AI 보이스 클로닝은 위의 전체 과정을 브라우저에서 처리합니다.
직접 부른 노래를 8~15분 추가합니다. 파일을 업로드하거나 라이브러리에서 곡을 고르면 됩니다. 반주는 자동으로 제거되고 무음도 잘려 나갑니다.
학습 품질을 고릅니다. 표준(50에포크), 고품질(100), 최고(150) 중에서 고르며 각각 150, 250, 350크레딧입니다. 반주를 제거한 뒤 깨끗한 노래가 3분 미만으로 남거나 학습에 실패하면 크레딧은 자동으로 환불됩니다.
약 15~40분 기다립니다. 학습은 표준 RVC v2 구성(48 kHz, RMVPE 피치 추출)으로 진행됩니다. 페이지를 닫아도 됩니다.
듣고, 쓰고, 다운로드합니다. 학습이 끝나면 새 목소리로 부른 짧은 샘플을 들려 드립니다. 이후 이 목소리는 AI 커버곡 생성기의 "내 보이스"에 나타나며, .pth와 .index 파일이 담긴 zip으로 모델을 다운로드해 다른 RVC 도구에서도 쓸 수 있습니다.
학습은 무료가 아닙니다. 빌린 GPU 시간을 쓰기 때문에 학습할 때마다 크레딧이 듭니다. 그 대신 GPU도, Python도, 파일 준비도 필요 없습니다.
RVC 모델은 몇 에포크 학습해야 하나요?
알아보기 위해 같은 목소리로 두 번 학습했습니다. 소스는 음색이 일정한 AI 가수(저희 버추얼 아티스트 JUNO)였고, 각 모델로 같은 테스트 곡을 변환했습니다.
| 테스트 | 학습 오디오 | 에포크 | GPU 시간 |
|---|---|---|---|
| 1차 | 완성곡 약 24분, 반주 포함 | 100 | 약 29분 |
| 2차 | 약 15분, 보컬 먼저 분리 | 50 | 약 9분 |
나란히 들어 보니 100에포크 모델이 조금 더 비슷했지만 차이는 작았습니다. 그래서 50에포크를 기본으로 두고 더 높은 등급은 선택 사항으로 두었습니다. 두 번의 학습은 학습 오디오도 달랐고, 한 목소리로 한 번 해 본 테스트일 뿐이니 규칙이 아니라 참고 데이터로 봐 주세요. 일반적으로 에포크를 늘리는 것보다 학습 오디오를 깨끗하게 하는 것이 더 중요하며, 데이터가 적은데 에포크를 너무 많이 돌리면 과적합될 수 있습니다.
RVC .index 파일은 효과가 있을까?
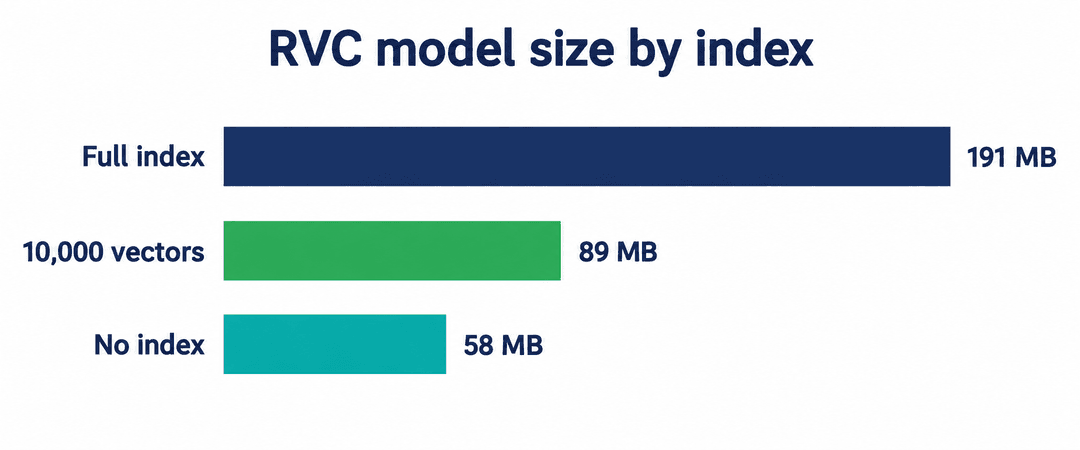
인덱스는 RVC 모델에서 가장 큰 부분이라 줄일 수 있는지 테스트했습니다. 50에포크 모델로, RVC 자체가 대용량 데이터셋에 쓰는 것과 같은 클러스터링 방식을 사용해 약 45,000개의 특징 벡터를 10,000개의 클러스터 중심으로 줄여 인덱스를 다시 만들었습니다.
| 버전 | 모델 zip 크기 | 청취 테스트 결과 |
|---|---|---|
| 전체 인덱스(45,162개 벡터) | 약 191 MB | 기준 |
| 10,000개 벡터로 축소 | 약 89 MB | 차이를 느끼지 못함 |
| 인덱스 없음(.pth만) | 약 58 MB | 차이를 느끼지 못함 |
이 테스트에서는 인덱스가 귀로 확연히 느낄 만한 차이를 만들지 않았고, 10,000개 벡터 버전에서 index rate를 올려도 들리는 소리는 달라지지 않았습니다. 다만 깨끗하고 일정한 AI 생성 목소리였기 때문에, 잡음과 변화가 더 많은 사람의 녹음에서는 다르게 나올 수 있으니 보편적인 규칙으로 여기지는 마세요. RaoMusic은 절충안으로 학습된 모든 모델에 10,000개 벡터 인덱스를 넣습니다. 업로드한 오디오 양과 관계없이 모델은 최대 약 90 MB입니다.
RVC 학습에서 흔한 실수
반주를 빼지 않고 완성곡으로 학습하기. 모델이 목소리와 함께 밴드 소리까지 학습합니다.
여러 가수를 섞기. 듀엣, 화음, 피처링이 들어가면 목소리가 모두의 평균처럼 흐려집니다.
음역이 너무 좁음. 모든 클립이 조용하고 낮으면, 변환 후 고음이 힘겹게 들립니다.
오디오는 그대로 두고 에포크만 늘리기. 깨끗한 보컬 10분이 잡음 섞인 30분보다 낫고, 에포크를 늘려도 나쁜 데이터는 고쳐지지 않습니다.
창법까지 옮겨질 거라 기대하기. RVC는 음색을 복사할 뿐 실력을 복사하지 않습니다. 커버곡에는 원래 가수의 비브라토, 애드리브, 표현이 그대로 남습니다.
자주 묻는 질문
RVC 모델은 Retrieval-based Voice Conversion으로 만든 AI 보이스 모델입니다. 기존 녹음 속 목소리를 학습된 목소리로 바꾸면서 가사, 멜로디, 타이밍은 유지합니다. 보통 .pth 가중치 파일과 선택 사항인 .index 파일로 구성됩니다.
.index 파일에는 학습 녹음의 특징이 저장되어 있습니다. 변환할 때 RVC는 여기서 가장 가까운 소리를 찾아 결과물을 그쪽으로 끌어당기므로, 목표 목소리에 더 가깝게 들릴 수 있습니다. 이 파일이 없어도 변환은 됩니다.
RVC 소프트웨어는 무료 오픈소스라서, 성능이 충분한 NVIDIA GPU가 있다면 로컬 학습은 무료입니다. Colab 노트북 같은 무료 온라인 방법은 제한이 있고 끊기거나 작동하지 않을 수 있습니다. 안정적인 온라인 학습 도구는 GPU 시간에 비용을 받으며, RaoMusic에서는 학습할 때마다 크레딧이 들고 학습에 실패하면 자동으로 환불됩니다.
대부분의 환경에서는 한 사람의 깨끗한 오디오 약 5~15분이면 됩니다. RaoMusic은 반주를 제거한 뒤에도 깨끗한 노래가 최소 3분 남도록 8~15분 업로드를 요청합니다.
정답은 하나가 아닙니다. 저희 테스트에서는 같은 목소리에서 100에포크가 50에포크보다 아주 조금 나았을 뿐이라, 50에포크로 시작하는 것이 합리적입니다. 에포크를 늘리는 것보다 학습 오디오를 깨끗하게 하는 편이 대개 더 효과적입니다.
대부분 가능합니다. 학습한 목소리는 RVC v2(48 kHz) .pth 파일과 .index 파일이 담긴 zip으로 다운로드되며, 대부분의 RVC v2 보이스 체인저에서 불러올 수 있습니다. 호환성은 해당 도구의 버전과 설정에 따라 다르므로, 본격적으로 쓰기 전에 그 도구에서 먼저 테스트해 보세요.
RVC v2는 v1보다 입력 오디오에서 더 풍부한 특징을 추출해, 특히 노래에서 대체로 더 선명하고 자연스러운 결과를 냅니다. 두 버전의 모델은 서로 호환되지 않으며, 현재 대부분의 도구는 v2를 기준으로 합니다.
내 목소리로 모델을 학습하는 것은 문제없습니다. 다른 사람의 목소리를 허락 없이 클로닝하면 퍼블리시티권, 당사자 동의, 플랫폼 정책 문제가 생길 수 있고, 그것으로 만든 곡을 공개하면 저작권 문제도 더해집니다. 내 목소리나 사용 허락을 받은 목소리만 클로닝하세요.