
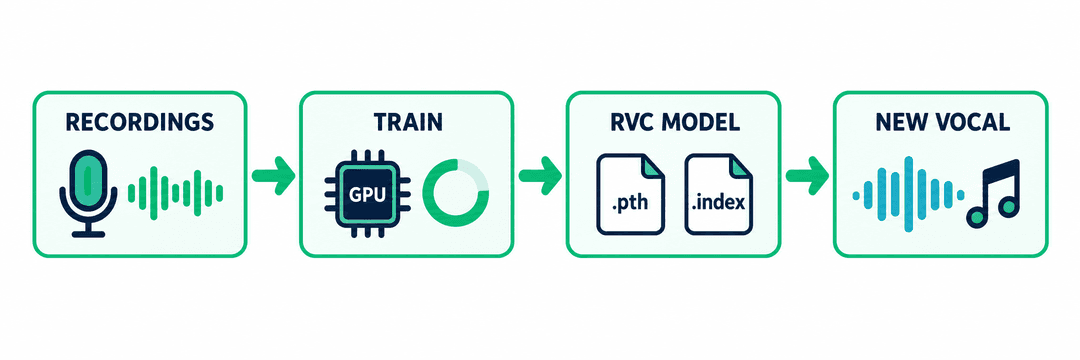
Kurz gesagt: Ein RVC-Modell ist ein kleines KI-Stimmmodell, das mit Retrieval-based Voice Conversion (RVC) erstellt wird – einem Open-Source-Verfahren, das die Stimme in einer Aufnahme austauscht und dabei Text, Melodie und Timing beibehält. Ein trainiertes RVC-Modell besteht meist aus zwei Dateien: einer .pth-Datei mit den Stimmgewichten und einer optionalen .index-Datei, die das Ergebnis näher an den ursprünglichen Sprecher oder Sänger heranbringt. Trainiert wird es mit wenigen Minuten sauberer Aufnahmen einer einzigen Stimme.
In der KI-Musik ist mit „RVC“ fast immer dieses Voice-Conversion-Modell gemeint, und „RVC Voice Cloning“ bedeutet, ein solches Modell auf eine bestimmte Stimme zu trainieren. Ein Großteil der KI-Cover, die online kursieren, ist damit entstanden.
Wofür steht RVC?
RVC steht für Retrieval-based Voice Conversion. Das RVC-Project hat es 2023 unter der MIT-Lizenz veröffentlicht. Seitdem gehört es zu den meistgenutzten Open-Source-Workflows für Stimmkonvertierung, weil es auf handelsüblichen NVIDIA-Grafikkarten läuft und oft weniger Trainingsaudio braucht als ältere Verfahren.
Entscheidend ist der Teil „Voice Conversion“. RVC schreibt weder Songtexte noch komponiert es Musik. Es nimmt eine vorhandene Gesangsaufnahme und vertont sie neu: Phrasierung, Tonhöhe und Rhythmus des Originalsängers bleiben erhalten, nur die Klangfarbe wird zur Stimme, auf die das Modell trainiert wurde.
Was ist ein RVC Voice Converter und wie funktioniert er?
Ein RVC Voice Converter ist jedes Tool, das ein RVC-Modell lädt und eine Aufnahme hindurchschickt. Vereinfacht passieren mit jedem konvertierten Gesang drei Dinge:
Was gesungen wird, wird von dem getrennt, wer singt. Ein Sprachmodell (HuBERT / ContentVec) wandelt den Eingangsgesang in Merkmale um, die die erzeugten Laute beschreiben – weitgehend unabhängig von der Identität des Sängers.
Die Tonhöhe wird verfolgt. Ein Pitch-Extraktor (meist RMVPE, alternativ Crepe oder Harvest) folgt der Melodie, damit die konvertierte Stimme dieselben Töne trifft. Für Männer-zu-Frauen- oder Frauen-zu-Männer-Konvertierung lässt sie sich um eine Oktave verschieben.
Das Audio wird in der Zielstimme neu aufgebaut. Der trainierte Generator macht aus diesen Merkmalen und der Tonhöhe wieder Klang – mit der Klangfarbe der Zielstimme.
Das „Retrieval“ im Namen ist der optionale Zwischenschritt: Vor dem Neuaufbau sucht RVC in den Trainingsaufnahmen (gespeichert in der .index-Datei) nach den ähnlichsten Lauten und schiebt die Merkmale in deren Richtung. Dadurch kann das Ergebnis näher daran rücken, wie die Zielstimme wirklich klingt.
Die Konvertierung ist eine gute Annäherung, keine perfekte Kopie: Je nach Ausgangsgesang und Modell hörst du eventuell noch wackelnde Töne, verwaschene Konsonanten oder hauchige Artefakte.
Was sind die .pth- und .index-Dateien in einem RVC-Modell?
Wenn jemand „ein RVC-Modell“ teilt oder verkauft, sind diese Dateien gemeint, meist in einem Zip-Archiv:
| Datei | Was sie ist | Typische Größe (RVC v2) | Erforderlich? |
|---|---|---|---|
| .pth | Die trainierten Stimmgewichte: der Teil, der die Stimme tatsächlich „ist“ | Oft rund 55 MB | Ja |
| .index | Ein durchsuchbarer Index mit Merkmalen aus dem Trainingsaudio, genutzt für das Retrieval | Von etwa 15 MB bis zu mehreren hundert MB | Nein, aber meist dabei |
Die genaue Größe hängt von Samplerate, Trainingstool und der Zahl der Merkmalsvektoren im Index ab. Die .index-Datei ist optional. Ohne sie funktioniert die Konvertierung trotzdem und nutzt nur die .pth. Mit ihr steuert die Einstellung „index rate“, wie stark das Ergebnis zur Trainingsstimme gezogen wird. Ein höherer Wert kann den Klang näher heranbringen, aber auch dumpfe oder blechern klingende Artefakte erzeugen, besonders bei verrauschtem Trainingsaudio. Es geht also um Balance, nicht um „je höher, desto besser“.
Der Index kann deutlich größer sein als die Gewichte. In unserem eigenen Test ergab das Training mit etwa 15 Minuten getrennter Vocals einen 136 MB großen Index neben einer 55 MB großen .pth – dazu eine 132 MB große Arbeitsdatei total_fea.npy, die die Trainingsskripte zurücklassen und die bei der Konvertierung nie verwendet wird.
Was ist der Unterschied zwischen RVC v1 und RVC v2?
RVC v2 ist die Version, die heute fast alle nutzen. Sie extrahiert reichhaltigere 768-dimensionale Merkmale aus dem Eingangssignal (v1 nutzte 256), was in der Regel klarere, natürlichere Ergebnisse liefert, vor allem bei Gesang. Modelle werden mit 32, 40 oder 48 kHz trainiert; für Musik sind 48 kHz die übliche Wahl.
Ein v1- und ein v2-Modell sind nicht austauschbar. Konvertierungstools müssen wissen, welche Version eine .pth-Datei hat, und die meisten aktiv gepflegten Tools sind auf v2 ausgelegt.
Woher kommen RVC-Modelle?
Es gibt zwei Quellen:
Geteilte Modelle. Community-Seiten und Repositories bieten Tausende RVC-Modelle an, viele davon imitieren echte Sänger, Schauspieler oder Figuren. Die meisten wurden ohne Zustimmung der Person hochgeladen, deren Stimme es ist, die Lizenzen sind oft unklar, und manche Dateien sind Trainings-Checkpoints statt nutzbarer Inferenzmodelle. Sei vorsichtig damit, vor allem bei allem, was du veröffentlichen willst.
Selbst trainierte Modelle. Wenn du auf deine eigene Stimme trainierst oder auf eine Stimme, für die du eine klare Erlaubnis hast, umgehst du diese Probleme. Außerdem ist es der einzige Weg zu einem Modell einer Stimme, die sonst niemand veröffentlicht hat.
Wenn du Cover mit der Stimme einer anderen Person singen willst, behandelt unser Ratgeber zu legalen KI-Covern die Fragen zu Einwilligung und Urheberrecht ausführlicher.
Wie trainiert man ein RVC-Modell?
Jedes RVC-Training folgt denselben Schritten:
Saubere Aufnahmen einer Stimme sammeln. Meist reichen 5 bis 15 Minuten Gesang (oder Sprache). Mehr Abwechslung (tiefe, mittlere und hohe Töne) zählt mehr als mehr Minuten.
Alles entfernen, was nicht Stimme ist. Begleitmusik, Hall, Harmonien und andere Sänger lernt das Modell sonst als Teil der Stimme mit. Ein Gesangsentferner hilft, wenn du nur fertige Songs hast.
Schneiden und vorverarbeiten. Das Audio wird in kurze Abschnitte zerlegt, Stille wird entfernt, und Tonhöhe sowie Merkmale werden extrahiert.
Eine festgelegte Zahl an Epochen trainieren. Eine Epoche ist ein Durchlauf durch das gesamte Trainingsaudio. Mehr Epochen dauern länger und bringen immer weniger zusätzlichen Gewinn.
Index erstellen und exportieren. Heraus kommen die .pth-Datei und die .index-Datei.
Wo kannst du das Training laufen lassen?
| Option | Was du brauchst | Gut für | Worauf du achten solltest |
|---|---|---|---|
| Lokale RVC WebUI (oder Forks wie Applio) | Eine aktuelle NVIDIA-GPU, eine Python-Umgebung, Speicherplatz | Volle Kontrolle, keine Kosten pro Durchlauf | Einrichtungsaufwand, Treiberprobleme, Dutzende Einstellungen |
| Google-Colab-Notebooks | Ein Google-Konto, für stabilen GPU-Zugang oft ein bezahlter Tarif | Keine lokale GPU nötig | Sitzungen brechen ab; Notebook- und Richtlinienänderungen machen Dinge kaputt; aktuelle Colab-Bedingungen prüfen |
| Entwickler-APIs (zum Beispiel Replicates train-rvc-model) | Ein API-Konto und eine Möglichkeit, das Dataset als Zip zu packen | Training in die eigene App einbauen | Dateivorbereitung, Webhooks und Speicher erledigst du selbst |
| Bezahlte Trainingsdienste | Die Zeit von jemand anderem | Einzelne Modelle | Bearbeitungszeit, Privatsphäre deiner Aufnahmen, schwankende Qualität |
| Online-Trainer wie RaoMusic | Einen Browser und deine Aufnahmen | Training ohne GPU oder Einrichtung, Stimme sofort nutzbar | Kostet Credits pro Trainingsdurchlauf |
Kann man ein RVC-Modell kostenlos online trainieren?
Teilweise. Die RVC-Software ist kostenlos und Open Source. Das Training auf deinem eigenen Rechner kostet also nichts außer Hardware und Strom – sofern du eine leistungsfähige NVIDIA-GPU hast. Kostenlose Online-Optionen sind weniger verlässlich: Die freie GPU-Zeit in Colab ist begrenzt und Sitzungen können mitten im Training abbrechen, Community-Notebooks gehen kaputt, wenn sich Abhängigkeiten ändern, und kostenlose Stufen von Trainings-APIs (falls es sie gibt) haben Kontingente. Training braucht GPU-Zeit, deshalb verlangen stabile Online-Trainer, auch RaoMusic, Geld dafür. Wenn dir „kostenlos“ am wichtigsten ist, ist lokales Training der realistische Weg; hast du keine GPU oder keine Lust auf die Einrichtung, spart dir ein Online-Trainer diese Zeit.
So trainierst du ein RVC-Stimmmodell online mit RaoMusic
KI-Voice-Cloning von RaoMusic erledigt die ganze oben beschriebene Pipeline im Browser:
8–15 Minuten deines eigenen Gesangs hinzufügen. Lade Dateien hoch oder wähle Songs aus deiner Bibliothek. Begleitmusik wird automatisch entfernt, Stille wird herausgeschnitten.
Trainingsqualität wählen. Standard (50 Epochen), Hoch (100) oder Maximal (150) für 150, 250 oder 350 Credits. Bleiben nach der Trennung weniger als 3 Minuten klarer Gesang übrig oder schlägt das Training fehl, werden die Credits automatisch erstattet.
Etwa 15–40 Minuten warten. Das Training ist ein Standard-RVC-v2-Setup: 48 kHz mit RMVPE-Pitch-Extraktion. Du kannst die Seite schließen.
Anhören, nutzen und herunterladen. Nach Abschluss wird eine kurze Hörprobe mit deiner neuen Stimme gesungen. Die Stimme erscheint dann unter „Meine Stimmen“ im KI-Cover-Song-Generator, und du kannst das Modell als Zip mit .pth- und .index-Datei herunterladen, um es in anderen RVC-Tools zu nutzen.
Das Training ist nicht kostenlos: Jeder Durchlauf kostet Credits, weil dafür gemietete GPU-Zeit anfällt. Dafür brauchst du keine GPU, kein Python und keine Dateivorbereitung.
Wie viele Epochen sollte man ein RVC-Modell trainieren?
Um das herauszufinden, haben wir dieselbe Stimme zweimal trainiert. Die Quelle war eine gleichbleibende KI-generierte Sängerin (unsere virtuelle Künstlerin JUNO), und wir haben mit jedem Modell denselben Testsong konvertiert:
| Test | Trainingsaudio | Epochen | GPU-Zeit |
|---|---|---|---|
| Durchlauf 1 | Etwa 24 Minuten komplette Songs, Begleitmusik nicht entfernt | 100 | Etwa 29 Minuten |
| Durchlauf 2 | Etwa 15 Minuten, Vocals vorher getrennt | 50 | Etwa 9 Minuten |
Im direkten Vergleich klang das Modell mit 100 Epochen etwas näher am Original, der Unterschied war aber gering. Deshalb sind 50 Epochen bei uns der Standard und die höheren Stufen optional. Die beiden Durchläufe unterschieden sich außerdem im Trainingsaudio, und es war ein einziger Test mit einer einzigen Stimme – sieh es also als Datenpunkt, nicht als Regel. Grundsätzlich ist sauberes Trainingsaudio wichtiger als zusätzliche Epochen, und sehr hohe Epochenzahlen können bei einem kleinen Datensatz zu Overfitting führen.
Macht die RVC-.index-Datei einen Unterschied?
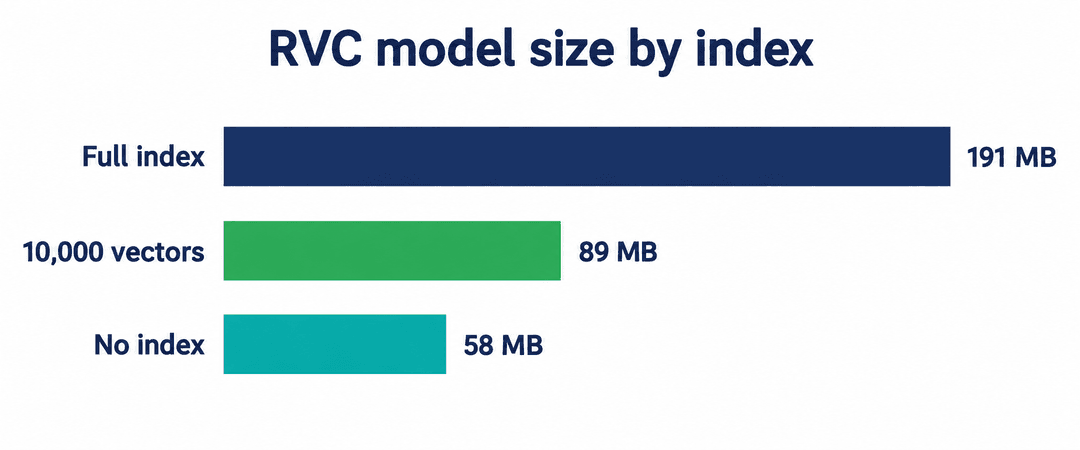
Der Index ist der größte Teil eines RVC-Modells, also haben wir getestet, ob er sich verkleinern lässt. Mit dem 50-Epochen-Modell haben wir den Index von etwa 45.000 Merkmalsvektoren auf 10.000 Clusterzentren reduziert – mit demselben Clustering-Ansatz, den RVC selbst bei großen Datensätzen verwendet:
| Version | Größe des Modell-Zips | Ergebnis in unserem Hörtest |
|---|---|---|
| Vollständiger Index (45.162 Vektoren) | Etwa 191 MB | Referenz |
| Index auf 10.000 Vektoren verkleinert | Etwa 89 MB | Kein Unterschied hörbar |
| Ohne Index (nur .pth) | Etwa 58 MB | Kein Unterschied hörbar |
In diesem Test machte der Index keinen deutlich hörbaren Unterschied, und auch eine höhere index rate bei der Version mit 10.000 Vektoren änderte nichts an dem, was wir hörten. Es handelte sich um eine saubere, gleichbleibende KI-generierte Stimme; menschliche Aufnahmen mit mehr Rauschen und Schwankungen können sich anders verhalten, also nimm das nicht als allgemeingültige Regel. RaoMusic behält in jedem trainierten Modell einen Index mit 10.000 Vektoren als Mittelweg: höchstens etwa 90 MB, egal wie viel Audio du hochlädst.
Häufige Fehler beim RVC-Training
Mit fertigen Songs trainieren, ohne die Musik zu entfernen. Das Modell lernt die Band gleich mit.
Mehrere Sänger mischen. Duette, Harmonien und Gastkünstler verschwimmen zu einer Durchschnittsstimme aus allen.
Zu wenig Tonumfang. Wenn jeder Clip leise und tief ist, klingen hohe Töne nach der Konvertierung gepresst.
Epochen hochschrauben statt das Audio zu verbessern. Zehn Minuten saubere Vocals schlagen dreißig Minuten verrauschte, und mehr Epochen reparieren keine schlechten Daten.
Eine Übertragung der Gesangstechnik erwarten. RVC kopiert die Klangfarbe, nicht das Können. Ein Cover behält Vibrato, Läufe und Phrasierung des Originalsängers.
Häufige Fragen
Ein RVC-Modell ist ein KI-Stimmmodell, das mit Retrieval-based Voice Conversion erstellt wird. Es verwandelt die Stimme in einer vorhandenen Aufnahme in die Stimme, auf die es trainiert wurde, und behält Text, Melodie und Timing bei. Es besteht in der Regel aus einer .pth-Datei mit den Gewichten und einer optionalen .index-Datei.
Die .index-Datei speichert Merkmale aus den Trainingsaufnahmen. Bei der Konvertierung sucht RVC darin nach den ähnlichsten Lauten und zieht das Ergebnis in deren Richtung, wodurch es näher an der Zielstimme klingen kann. Die Konvertierung funktioniert auch ohne sie.
Die RVC-Software ist kostenlos und Open Source, lokales Training kostet also nichts, wenn du eine leistungsfähige NVIDIA-GPU hast. Kostenlose Online-Optionen wie Colab-Notebooks sind begrenzt und können abbrechen oder nicht mehr funktionieren. Stabile Online-Trainer berechnen GPU-Zeit; bei RaoMusic kostet jeder Trainingsdurchlauf Credits, und schlägt das Training fehl, werden sie automatisch erstattet.
Die meisten Setups funktionieren mit etwa 5 bis 15 Minuten sauberem Audio einer Stimme. RaoMusic verlangt 8 bis 15 Minuten Uploads, damit nach dem Entfernen der Begleitmusik mindestens 3 Minuten klarer Gesang übrig bleiben.
Eine einzig richtige Zahl gibt es nicht. In unserem Test klangen 100 Epochen bei derselben Stimme nur etwas besser als 50, daher sind 50 ein sinnvoller Ausgangspunkt. Saubereres Trainingsaudio bringt meist mehr als zusätzliche Epochen.
In der Regel ja. Trainierte Stimmen werden als Zip mit einer RVC-v2-.pth-Datei (48 kHz) und einer .index-Datei heruntergeladen, die sich in den meisten RVC-v2-Voice-Convertern laden lassen. Die Kompatibilität hängt von Version und Einstellungen des jeweiligen Tools ab, also teste es dort, bevor du dich darauf verlässt.
RVC v2 extrahiert reichhaltigere Merkmale aus dem Eingangsaudio als v1, was meist klarere und natürlichere Ergebnisse liefert, besonders bei Gesang. Die beiden Versionen sind nicht austauschbar, und die meisten aktuellen Tools erwarten v2.
Ein Modell deiner eigenen Stimme zu trainieren ist unproblematisch. Die Stimme einer anderen Person ohne Erlaubnis zu klonen, kann Probleme mit Persönlichkeitsrechten, Einwilligung und Plattformrichtlinien verursachen, und wer damit erstellte Songs veröffentlicht, wirft zusätzlich urheberrechtliche Fragen auf. Klone nur Stimmen, die dir gehören oder für die du eine Erlaubnis hast.